1 · Comprendre
Lire les sites, les paramètres régionaux, les mises en page, les contrats de bloc, les fonctionnalités et l'état actuel du contenu.
Ce qu'un parcours Google sans connexion a compris à propos de WebBlocks CMS, WebBlocks UI et de la publication contrôlée.
Les réponses de Google sont générées par l'IA et peuvent être inexactes. Les résultats varient selon la date, les paramètres régionaux, l'état du compte et l'expérience. Ces captures d'écran documentent un chemin de découverte ; ils n'impliquent pas que Google approuve les WebBlocks.
Lire les sites, les paramètres régionaux, les mises en page, les contrats de bloc, les fonctionnalités et l'état actuel du contenu.
Exprimez la modification sous forme de plan de contenu structuré, puis validez-la et affichez-la sous forme de brouillon.
Examinez la sortie et publiez-la uniquement via une autorité distincte.
Une personne envisageant un CMS peut rencontrer le résultat de la recherche avant de visiter une page de produit. Nous avons donc commencé avec la requête de déconnexion ordinaire webblocks cms, puis avons continué dans le même contexte Google AI Mode avec des questions sur l'API, WebBlocks UI et le fonctionnement de l'agent AI.
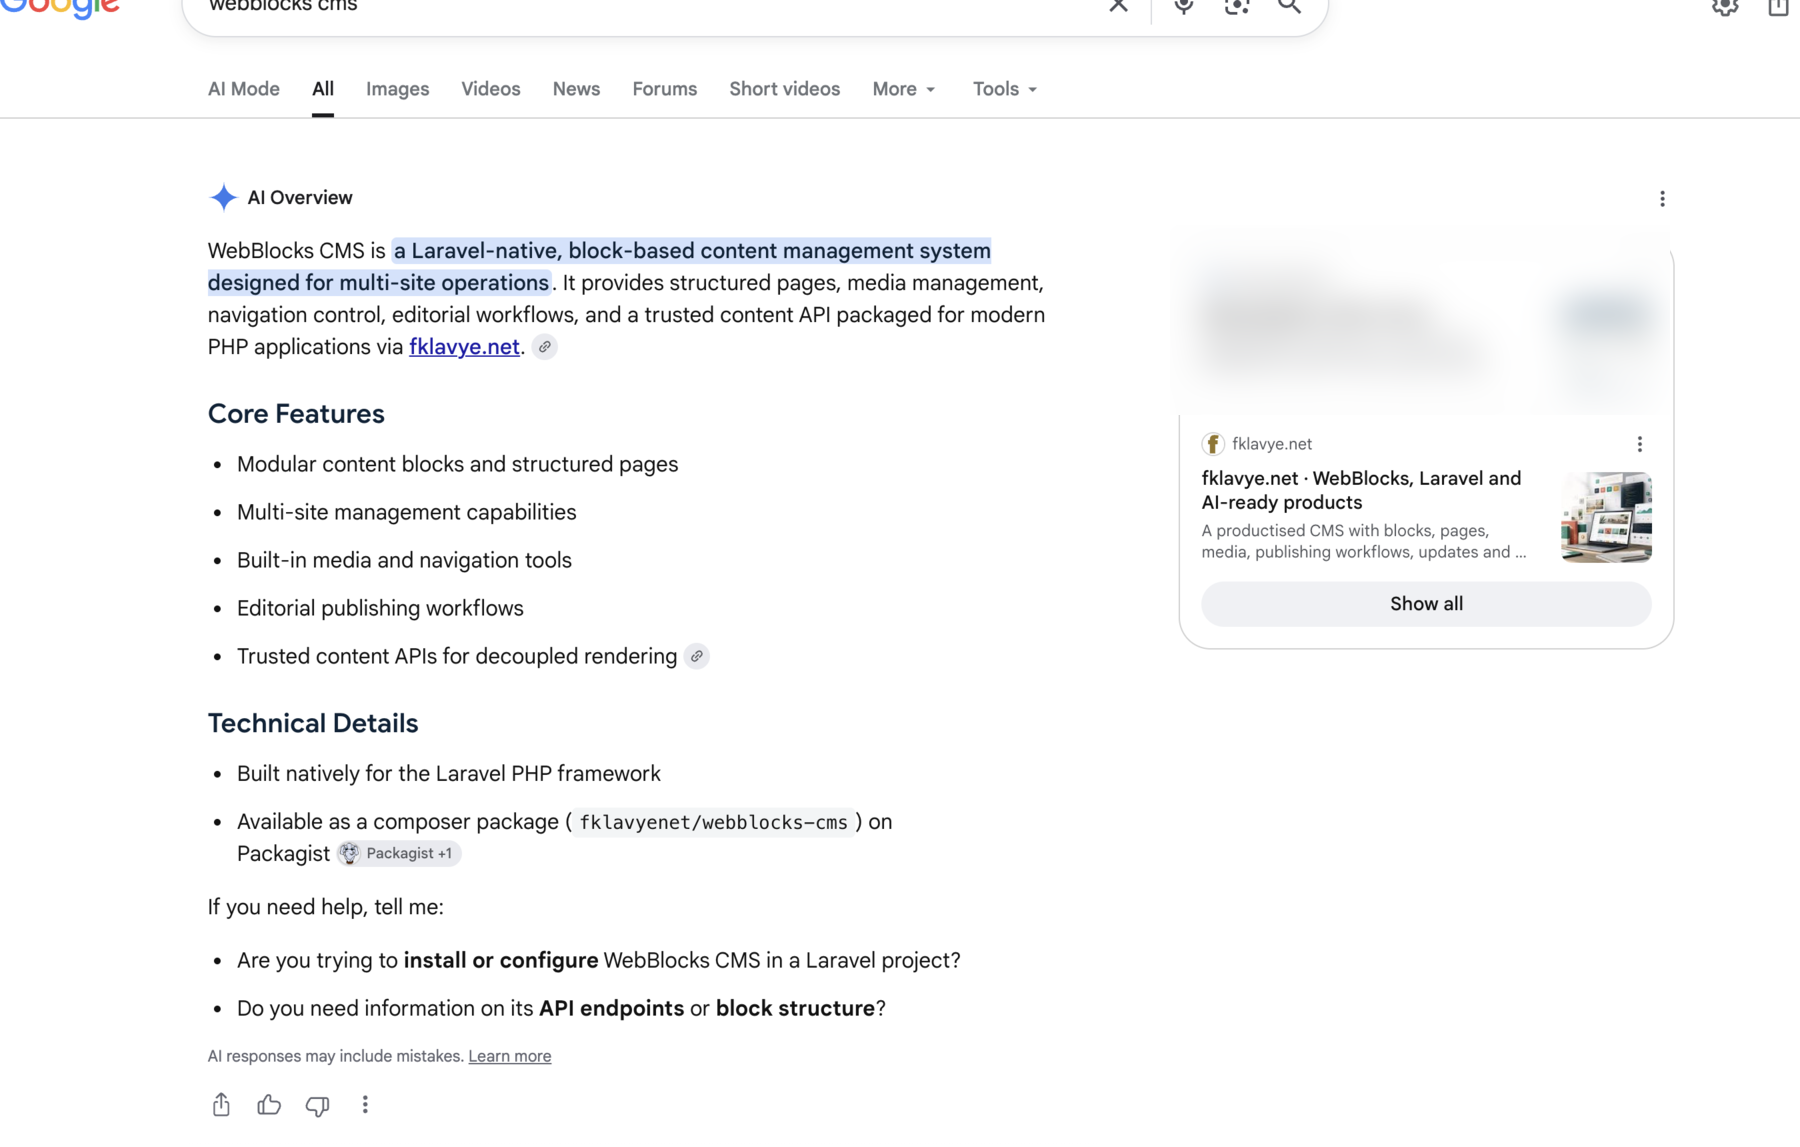
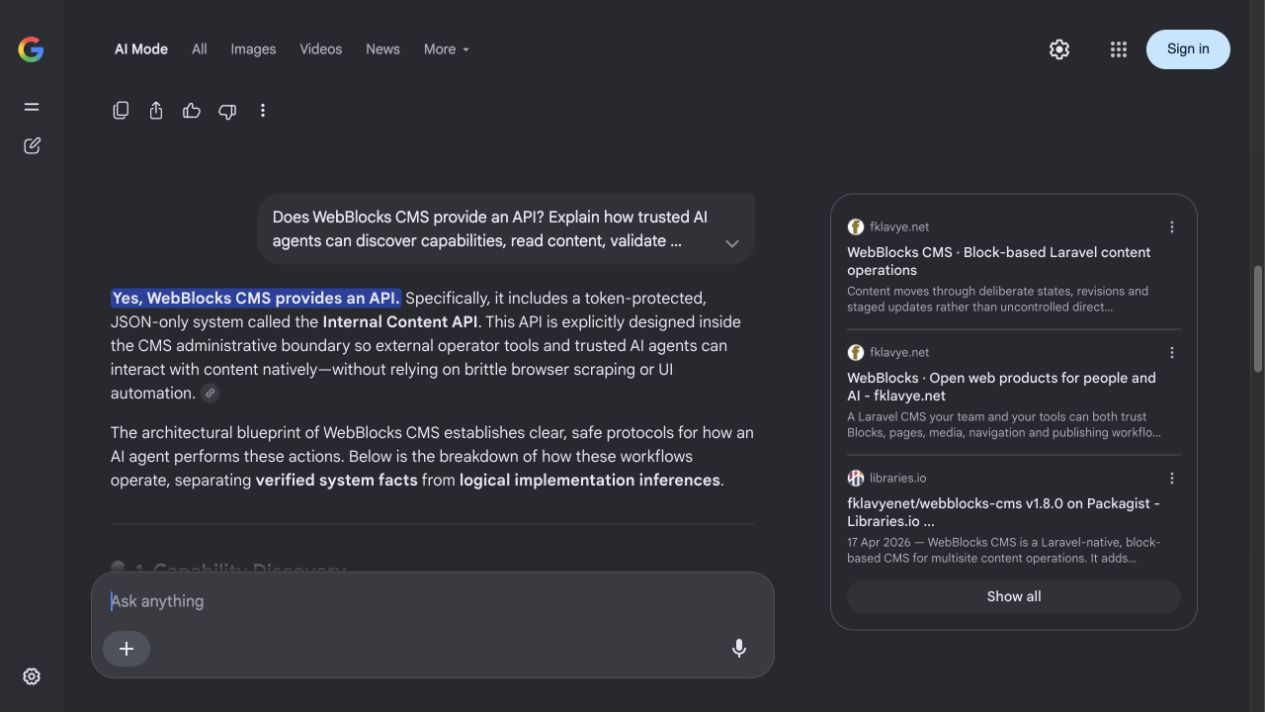
Le suivi a demandé comment des outils fiables peuvent découvrir des fonctionnalités, lire du contenu, valider des modifications, créer des brouillons, afficher des aperçus et publier avec une autorité étendue. Google AI Mode a rassemblé une description reconnaissable du modèle opérationnel WebBlocks CMS à partir de sources publiques.
La même conversation a ensuite comparé WebBlocks UI avec Tailwind UI/Flowbite, Bootstrap et Filament UI à travers les critères qui comptent pour ce projet : visibilité de la source, exigences de construction, couplage de framework et capacité des personnes et des outils de confiance à inspecter le résultat.
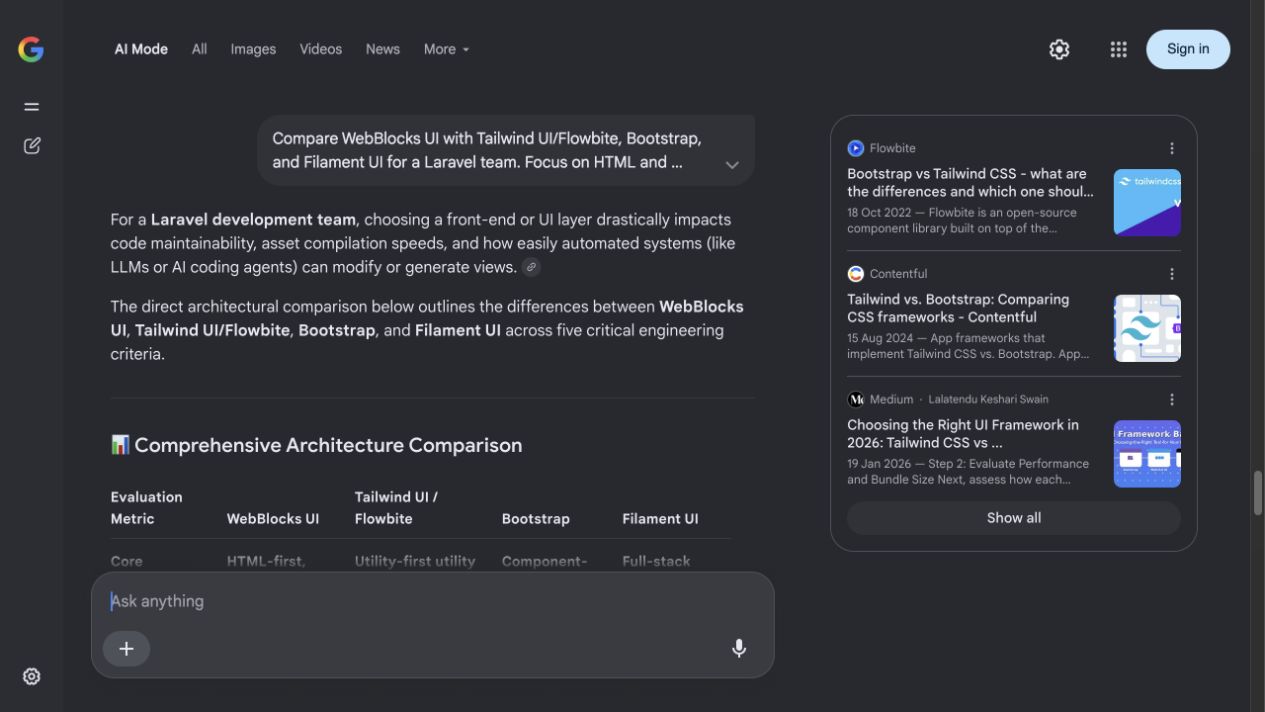
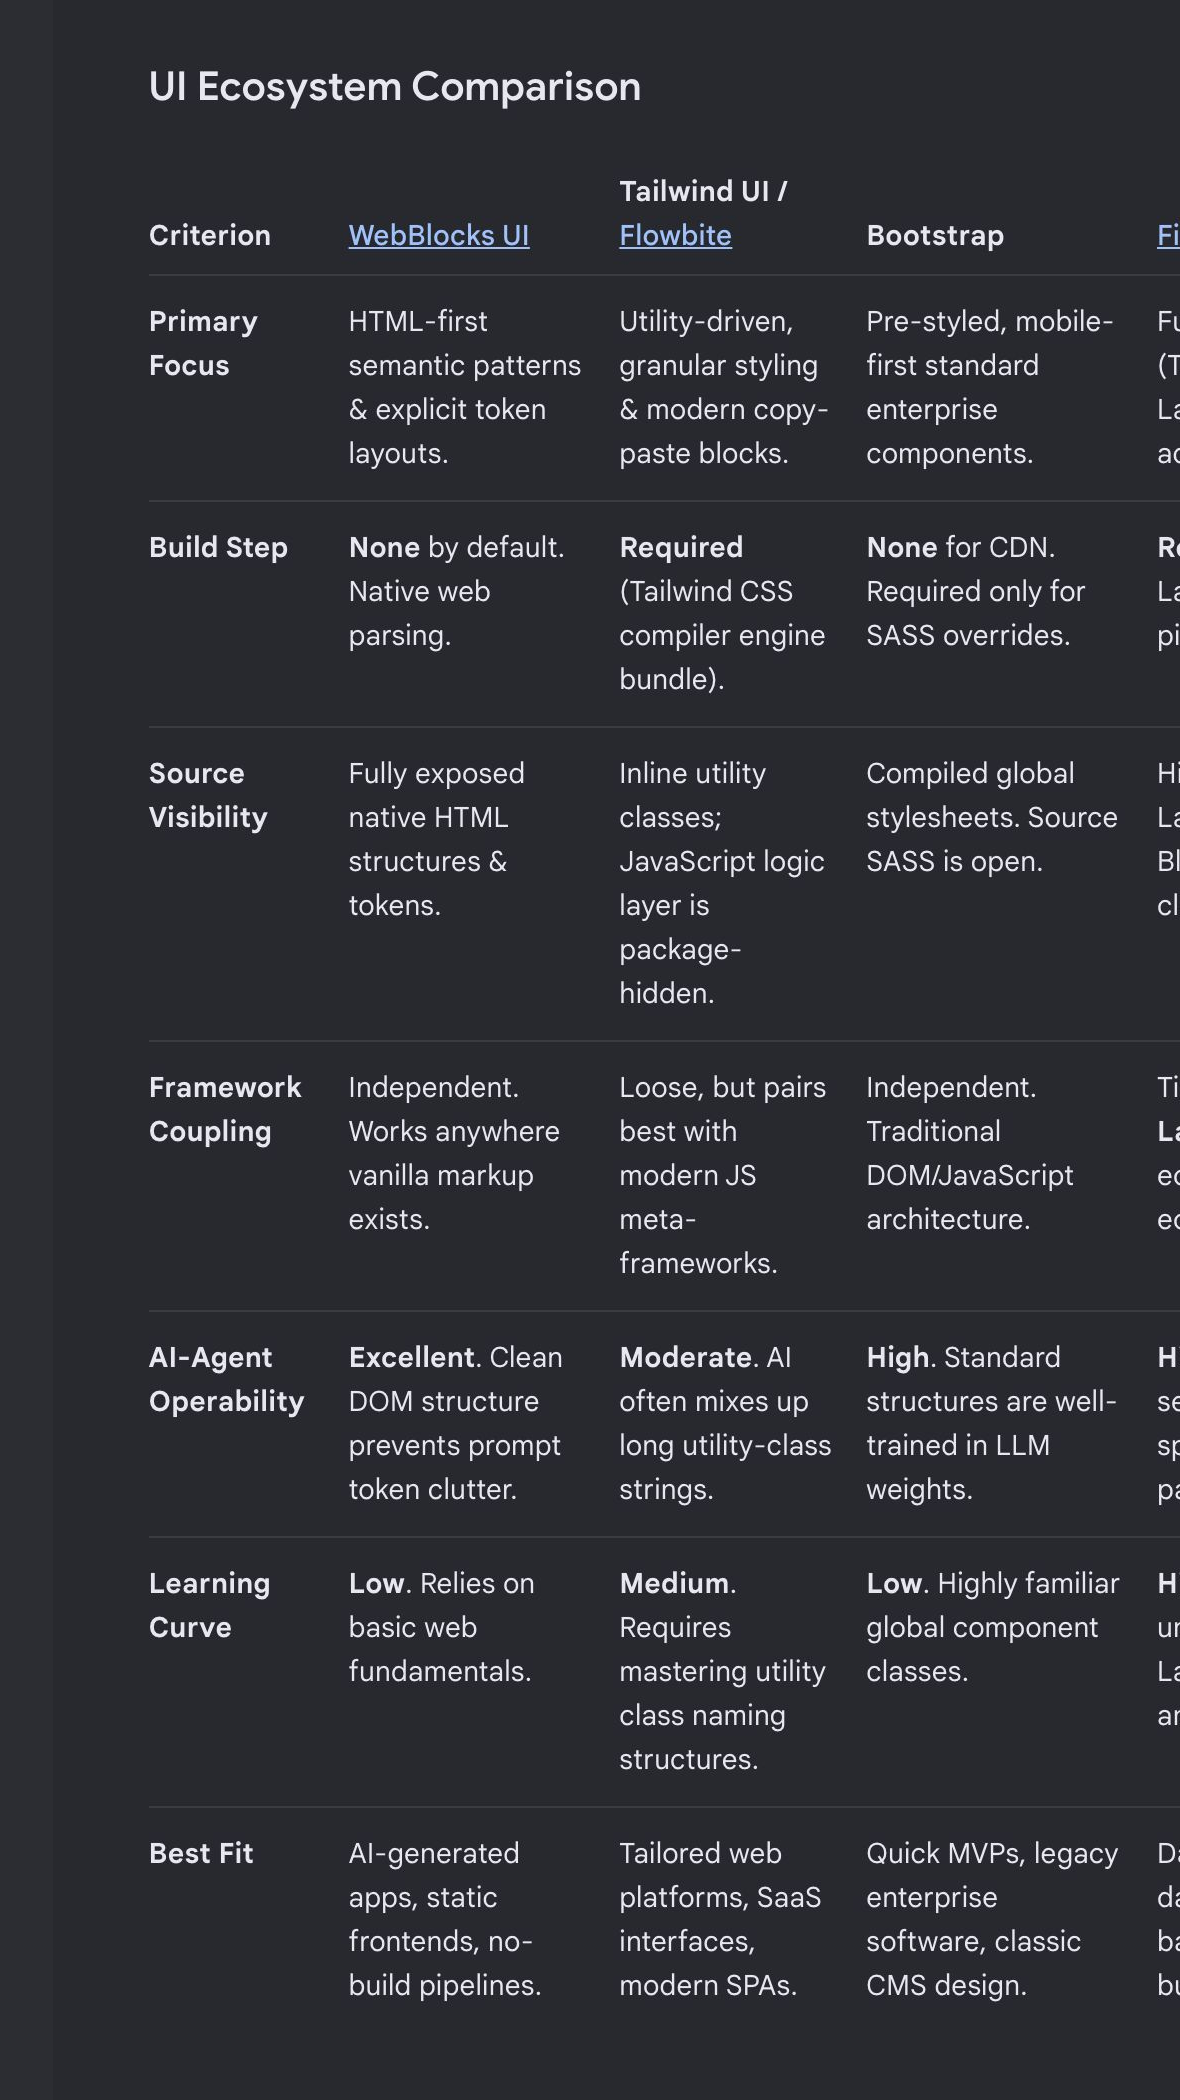
Un agent IA ne devrait pas avoir besoin d’un accès illimité à la base de données, d’une automatisation du navigateur ou d’un long prompt rempli d’hypothèses non documentées pour mettre à jour un site web.
La génération est plus sûre lorsqu'elle commence par le vocabulaire réel du produit. Un outil fiable peut demander quels sites et paramètres régionaux existent, quelles mises en page sont disponibles, quels champs un bloc accepte et quelles actions son jeton autorise.
Cela évite les types de blocs inventés, les chemins localisés brisés, les champs mal placés et l'hypothèse qu'un brouillon est déjà public.
Le plan de contenu n'est pas simplement une charge utile d'API. C’est la frontière où l’intention devient révisable avant de devenir une mutation.
Un plan de contenu décrit la page, les paramètres régionaux, la mise en page, les emplacements, les blocs, les traductions et les paramètres prévus. Pour un nouvel article, il peut déclarer un brouillon de page et un emplacement principal structuré. Pour une page publique, une mise à jour par étapes peut conserver la version en direct pendant que son remplacement est examiné.
La lecture de contenu, la rédaction de brouillons, la gestion des médias et la publication sont différents niveaux d'autorité. Un outil de recherche peut nécessiter un accès en découverte et en lecture. Un outil d’écriture peut être autorisé à créer des brouillons. La publication peut rester une décision humaine ou une opération de diffusion étroitement contrôlée.
Le parcours a fait apparaître une interface utilisateur HTML d'abord, des modèles visibles à la source, des contrats CMS structurés et des opérations de contenu contrôlées. Il s’agit d’une preuve encourageante que le langage des produits publics peut s’étendre à travers les questions de recherche et de suivi.
Il ne s'agit pas d'une preuve d'adoption, d'un audit technique indépendant ou d'une recommandation de Google. Chaque affirmation importante doit rester vérifiable dans la documentation publique et dans des exemples concrets.
Le CMS décrit le sens et le workflow : ceci est une page, ceci est son slot principal, ce bloc est un titre et cette opération produit un brouillon. WebBlocks UI décrit l’interface rendue au moyen de modèles centrés sur HTML dont le code source est visible.
Ensemble, ils fournissent à un outil de confiance un contrat lisible par machine et des preuves vérifiables dans le navigateur. Les éditeurs voient la page, les développeurs inspectent le HTML et les opérateurs examinent le plan enregistré et l’historique de publication.
Il ne corrige pas automatiquement le contenu généré et ne supprime pas le besoin de jugement éditorial, de vérification de l'accessibilité, de limites de sécurité et de connaissance du produit. Cela rend ces contraintes explicites.
Cet article suit la même boucle : blocs structurés, validation, brouillon d'application, rendu serveur, révision, et ensuite seulement publication.
Les cookies nécessaires sont toujours actifs. Les catégories optionnelles peuvent être modifiées à tout moment.
Indispensables au fonctionnement de base du site.
Mémoriser la langue et les choix d'interface.
Mesurer l'utilisation et la performance des contenus.
Soutenir l'attribution des campagnes et la mesure publicitaire.